
In hoofdstuk 5 van Dit is AI gebruikt Ilyaz Nasrullah de toeslagenaffaire als voorbeeld van wat er mis kan gaan als we te veel vertrouwen op geautomatiseerde risicobeoordeling. Hij noemt de affaire ‘een van de grootste AI-schandalen ter wereld’. Zijn belangrijkste punt is dat een risicomodel niet vanzelf objectief wordt doordat een computer de berekening uitvoert. Mensen bepalen welke gegevens worden gebruikt, welke kenmerken belangrijk worden gevonden en wat er met een uitkomst gebeurt. Dat is een terechte waarschuwing, maar Nasrullah gaat in dit hoofdstuk wat mij betreft te kort door de bocht door de hele toeslagenaffaire als een AI-schandaal te presenteren. En gaat het hier eigenlijk wel om AI, of om een eenvoudig algoritmisch classificatiemodel?
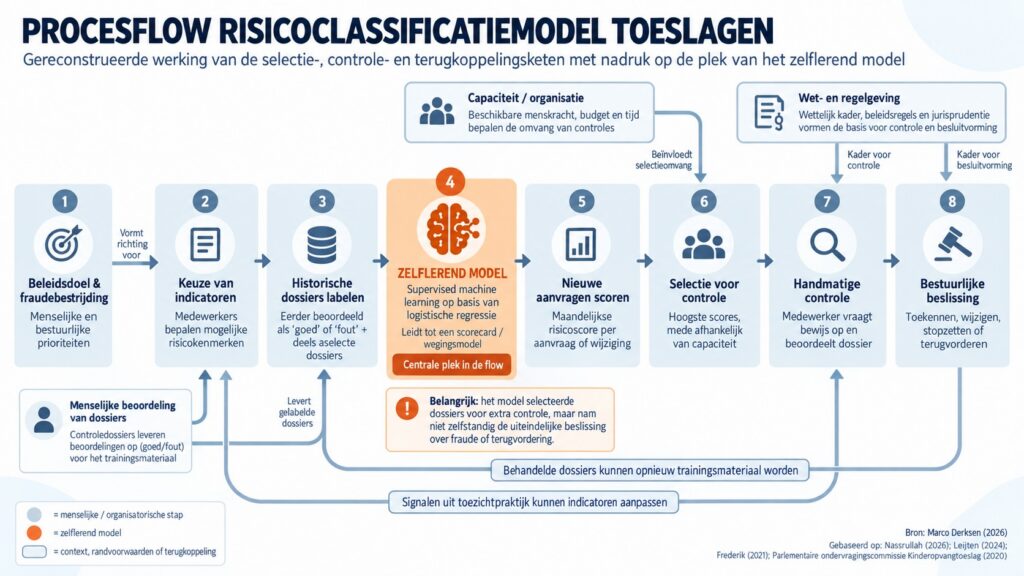
Wie ook kijkt naar de reconstructies van Renske Leijten en Jesse Frederik en naar het parlementaire eindverslag Ongekend onrecht, ziet een breder verhaal. De problemen begonnen niet bij het risicomodel. Ze kwamen voort uit een combinatie van harde wetgeving, streng fraudebeleid, groepsgewijze controles, de alles-of-nietsbenadering, het label ‘opzet/grove schuld’ en gebrekkige rechtsbescherming. De parlementaire commissie concludeerde daarom dat niet alleen de Belastingdienst faalde, maar ook de wetgever en de rechtspraak. De rol van het risicomodel was belangrijk, maar het model was slechts één schakel in een veel grotere keten.
Was er eigenlijk sprake van AI?
Ik ben er opnieuw ingedoken en Nasrullah heeft gelijk, het antwoor is ja, maar minder spectaculair dan het label ‘AI-schandaal’ doet vermoeden. De Belastingdienst gebruikte vanaf 2013 een zelflerend risicomodel. Medewerkers bepaalden welke kenmerken in het model terechtkwamen, waarna het model op basis van eerdere juiste en onjuiste aanvragen leerde welke kenmerken samenhingen met een mogelijk fout dossier. Technisch valt zo’n model onder machine learning en daarmee in brede zin onder AI.
Tegelijk is het belangrijk om AI niet gelijk te stellen aan een systeem dat zelfstandig beslissingen neemt. Dat deed dit model niet. Het gaf aanvragen een risicoscore en hielp bepalen welke dossiers extra gecontroleerd moesten worden. Omdat de capaciteit voor handmatige controle beperkt was, werden vooral de aanvragen met de hoogste risicoscores geselecteerd voor nader onderzoek. Die dossiers werden vervolgens door medewerkers beoordeeld. In die selectie speelde ook nationaliteit een rol; dat gebruik is later door de Autoriteit Persoonsgegevens als onrechtmatig en discriminerend beoordeeld.
De meest precieze formulering is daarom niet dat ‘AI bepaalde wie fraudeur was’, maar dat een zelflerend risicomodel mede bepaalde welke aanvragen extra aandacht van de Belastingdienst kregen.
Welke rol speelden de algoritmen in het geheel?
Die rol was belangrijk, maar kleiner dan het label ‘AI-schandaal’ doet denken. Zoals gezegd hielp het risicomodel bepalen welke burgers extra werden gecontroleerd. Daardoor konden bestaande aannames en selectiecriteria op grote schaal worden toegepast. Dat is niet zonder gevolgen: wie vaker wordt gecontroleerd, loopt ook meer kans dat fouten of onvolkomenheden worden gevonden en dat een zwaarder controleproces begint. Dat nationaliteit daarbij als kenmerk kon meewegen, maakt die selectie extra problematisch.
Tegelijk lag er een lange keten van menselijke en organisatorische beslissingen tussen een risicoscore en de uiteindelijke schade voor ouders. Medewerkers vroegen bewijsstukken op en beoordeelden die. Groepen ouders werden intensief gecontroleerd, toeslagen konden worden stopgezet en door de alles-of-nietsbenadering kon een heel jaar aan toeslag worden teruggevorderd. Het label ‘opzet/grove schuld’ kon een persoonlijke betalingsregeling blokkeren. Bezwaren werden soms laat of onvoldoende onafhankelijk behandeld en ook de bestuursrechter hield de strenge uitleg jarenlang in stand. Ongekend onrecht wijst juist op deze combinatie van harde uitvoering en gebrekkige rechtsbescherming.
Ook Jesse Frederik en Renske Leijten laten zien dat de affaire niet kan worden teruggebracht tot één algoritme of één afdeling. CAF kon bijvoorbeeld niet zelf toeslagen stopzetten en besliste niet over bezwaar, terugvordering of rechtspraak. Hun reconstructies laten vooral een lange keten zien van beleid, wetgeving, uitvoering, politieke druk en juridische keuzes, waarin ouders vaak moeilijk gehoor vonden.
Daar komt nog iets bij: de zwaarste problemen bestonden al voordat het zelflerende risicomodel vanaf 2013 werd gebruikt. Belastingdienst/Toeslagen koos al in 2009 voor een strenge alles-of-nietsbenadering, waarbij een tekortkoming kon leiden tot volledige terugvordering. De Raad van State liet die lijn vervolgens jarenlang in stand. Het risicomodel kan dus een rol hebben gespeeld bij de vraag wie extra werd gecontroleerd, maar het was niet de oorsprong van de harde terugvorderingspraktijk.
Conclusie en reflectie
Nasrullah heeft goede reden om de toeslagenaffaire in een boek over AI te bespreken. De Belastingdienst gebruikte daadwerkelijk een zelflerend risicomodel om aanvragen te selecteren voor extra controle. Zijn bredere punt dat automatisering menselijke keuzes niet vanzelf objectief maakt, blijft daarom relevant.
Ik zou het alleen zelf wat meer hebben genuanceerd en vooral ook andere voorbeelden wat nadrukkelijker hebben beschreven. Nasrullah beschrijf in het hoofdstuk kort voorbeelden als Slimme Check van de Gemeente Amsterdam, ProKid+ van de Amsterdamse politie en Lavender van de Israelische krijgsmacht.
De typering van de affaire als ‘een van de grootste AI-schandalen ter wereld’ gaat wat mij betreft te ver en blijkt ook niet uit de verschillende bronnen. Het label legt daarmee te veel nadruk op de technologie. Het risicomodel was één onderdeel van een veel grotere keten van wetgeving, beleid, uitvoering, menselijke beoordelingen, bezwaarprocedures en rechtspraak. Het model selecteerde dossiers, maar besliste niet zelfstandig over fraude, terugvordering of sancties. Dat doet overigens niets af aan de ernst van de affaire of de impact op de gedupeerden. Het maakt vooral duidelijker waar de technologie invloed had en waar de verantwoordelijkheid bij mensen en instituties lag.
Bronnen
- Nasrullah, I. (2026). Dit is AI: De valse belofte van kunstmatige intelligentie. Uitgeverij Nieuwezijds. Bureau ISBN
- Leijten, R. (2024). Leuker kunnen we het niet maken. Xander Uitgevers.
- Frederik, J. (2021). Zo hadden we het niet bedoeld: De tragedie achter de toeslagenaffaire. De Correspondent.
- Parlementaire ondervragingscommissie Kinderopvangtoeslag. (2020). Ongekend onrecht: Verslag Parlementaire ondervragingscommissie Kinderopvangtoeslag (Kamerstuk 35 510, nr. 2). Tweede Kamer der Staten-Generaal.
- Autoriteit Persoonsgegevens. (2020, 17 juli). Werkwijze Belastingdienst in strijd met de wet en discriminerend.
2 reacties
Je raakt een stukje van een misschien wel filosofischer punt: is AI niet überhaupt “gewoon” Algoritmische Informatievoorziening” en zorgt de taal en projectie ervoor dat wij de mens als verantwoordelijke buiten beeld zetten?
Modellen ontsnappen niet. Ze doen wat een bedrijf ze heeft geprogrammeerd te doen. En daarmee is het model niet “rogue”, maar het bedrijf. Die scherpte vervaagt, wanneer wij aan het model en de algoritmes eigenschappen gaan toekennen die niet in lijn zijn met wat er werkelijk gebeurt: het doet waarvoor het is ontworpen. Ook al “leert” het model (nee het past statistisch een aanpassing toe die convergeert naar een ingegeven optimalisatiepunt), dan nog is de mens verantwoordelijk. Het toeschrijven van menselijke eigenschappen mag dat niet verhullen. Voor het programmeren én de uitkomst van de vergelijkingen blijft die mens de oorzaak. Inclusief de aanpassingen die het model volgens hoe het is geprogrameerd, doet. Wanneer wij de bedrijven (en de besturen persoonlijk) direct verantwoordelijk gaan houden voor de uitkomsten, gaan wij heel andere discussies krijgen, denk ik.
Goed punt en helemaal mee eens. Schreef daar eerder ook al over in “De mens achter de AI”: https://upstream.nl/2026/08/08/de-mens-achter-de-ai/